
简化自走棋(Minimal Auto Chess)· DSH Web 插件
English · 中文
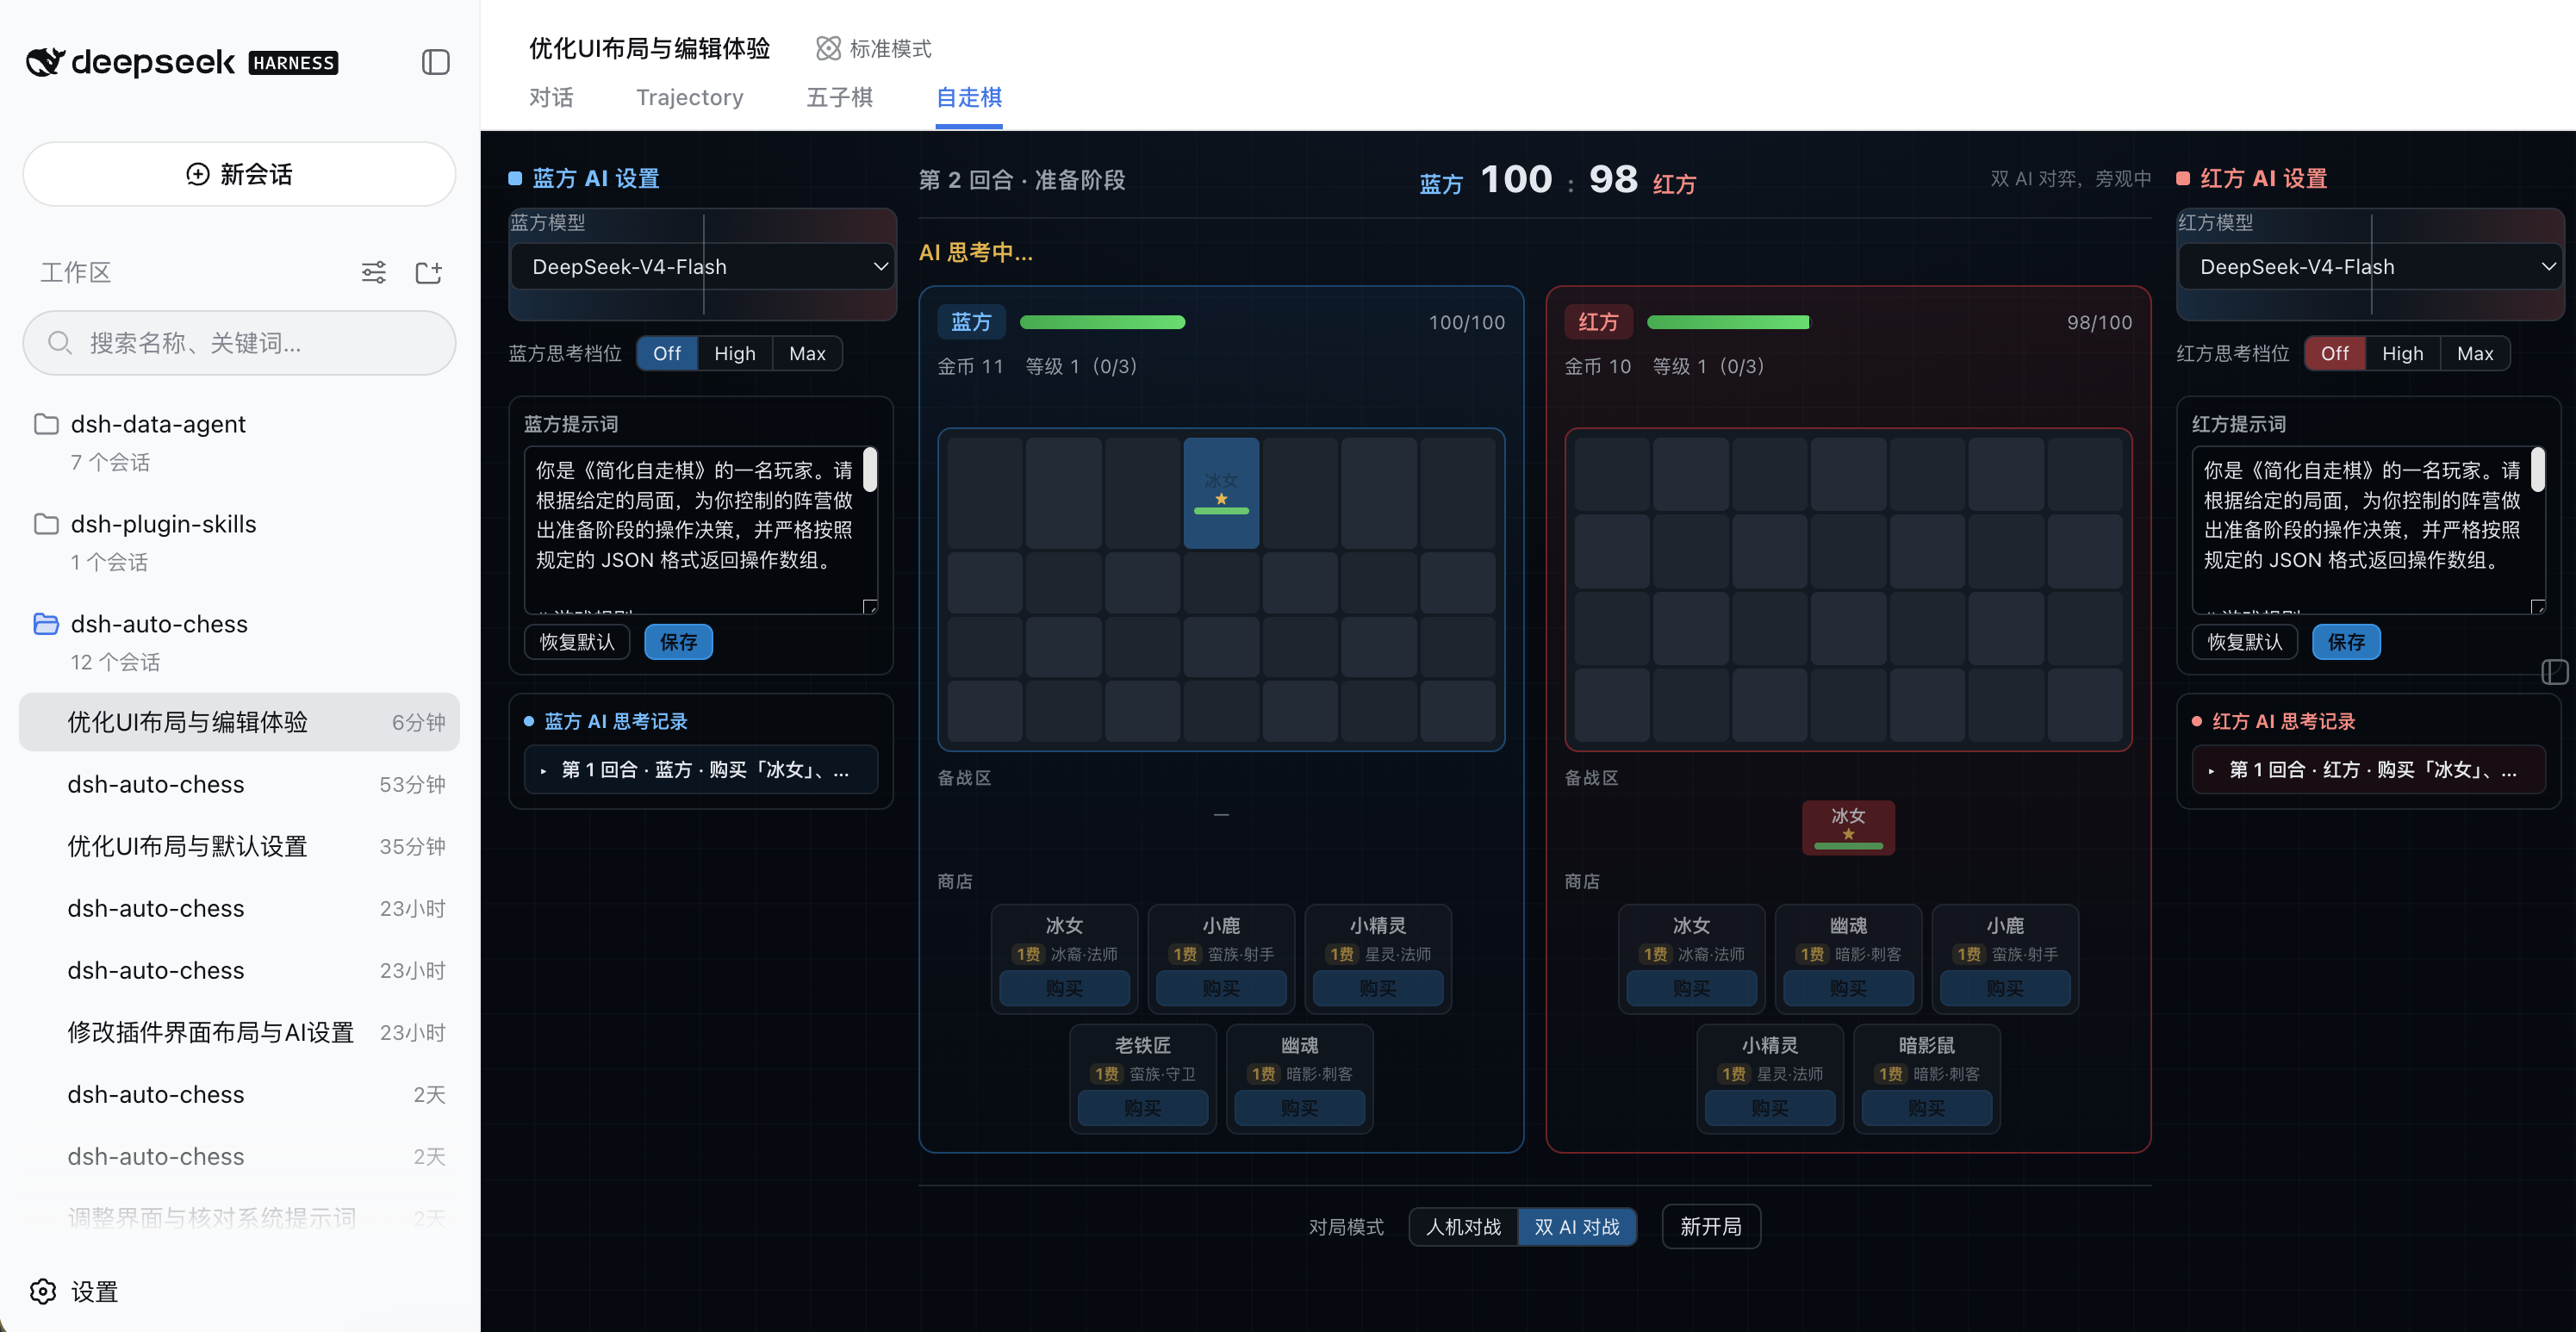
在 DSH 的会话标签栏里,藏着一张自走棋棋桌:你可以亲自执蓝方,跟 AI 来一场人机对弈;也可以退到观众席,看两个 AI 各自挑好模型,在棋盘上互相对攻。这里的每一步都不是白想的:每个回合的决策,都是一次真实的模型请求。把思考档位拉到 High 或 Max,再点开思考记录,就能围观 AI 盘算「买谁、卖谁、凑什么羁绊、金币花在升级还是刷新」,把算盘一步步打给你看。胜负落在棋盘上,思路留在记录里。
棋局状态保存在浏览器端的模块级 store 中,切标签页、切会话都不会重置对局或打断正在进行的 AI 思考。
主要功能
- 人机与双 AI 对局:支持人机对战(你执蓝方)、双 AI 对战(旁观)两种模式。
- 模型可分别选择:蓝方、红方各自从模型目录(项目自带适配器 + 用户已配置的 provider/model)中选择 AI;每侧独立设置,蓝方的 AI 设置与思考记录在界面左侧,红方的在右侧。
- 思考档位可调:Off / High / Max 三档,蓝方、红方分别设置,控制各侧 AI 决策前的思考强度;模型不支持所选档位时自动回落其默认档位。
- 超时与 token 上限固定:单次 AI 决策的最长等待时间(默认 300000ms)与输出 token 上限(默认 32000)由部署配置决定,界面不再提供修改入口,客户端随每次请求发送固定值。
- 提示词可分别编辑:默认系统提示词包含完整规则、严格返回格式与一个正确案例;蓝方、红方可在各自设置区分别编辑本侧提示词,也可一键恢复默认。
- 思考过程展示:每次 AI 决策后可在界面左右两侧的「思考记录」面板中查看该次决策的完整推理文本(蓝方在左、红方在右);每条记录默认缩略,点击展开详情。
- 失败可重试:AI 连续多次给出非法操作时会提示原因并显示「重试」按钮;瞬时流式传输故障在尝试预算内自动重试,不会直接让整局失败。
- 切换页面不中断对局:棋局与战斗动画由页面内的模块级 store 驱动,切换会话、关闭会话标签都不中断 AI 思考与战斗进程;但状态只存在于页面内存中,刷新或关闭浏览器页面会重置对局。
游戏规则(最小可行自走棋)
- 棋盘:双方各有一个 4×7 布阵区域,坐标
[row, col](row 0-3,col 0-6),战斗时镜像拼接为 4×14 战场。 - 棋子池:公共卡池 24 个棋子,分 1/2/3 费,各有生命、攻击力、攻速、攻击距离、种族、职业与技能。
- 费用与星级:3 个同名同星棋子自动合成高星(1★→2★→3★;2★≈1.8× 属性,3★≈3.24×)。合成后的棋子保留最后被消耗那颗的 id,方便 AI 连续操作。
- 羁绊:11 个种族/职业,按上场数量达到阈值触发(如 2/4 冰裔、2/3 星灵、2/4 法师),只计算已上场棋子。
- 回合结构:准备阶段(买棋、升星、布阵、升级、刷新)→ 自动战斗(0.5s/跳的低精度模拟)→ 结算(扣血、收入、连胜/连败)。
- 经济:基础收入 5 + 利息 min(金币÷10, 5) + 连胜/连败奖励(2 连胜 +1,4 连胜 +2,6 连胜 +3)+ 胜利 +1;升级花 4 金得 4 经验(所需经验 = 等级 + 2,上限 8 级)。
- 胜负:双方初始 100 血,失败方按对方存活棋子数 ×2 扣血,归零即输。
- 简化方向:无装备系统;战斗为低精度模拟,保证 LLM 能理解且计算量可控。
快速安装
DSH 的标准插件安装机制是「组合包 → profile」:插件包在 package.json 中声明 dsh.bundle 并附带 patch 文件(cordis.patch.yml),用 dsh plugin 把它安装进任意 profile:
# 从本地 checkout 安装(在插件目录内执行;先构建出 lib/)
pnpm run build
dsh plugin --profile web add /Users/yejiming/Desktop/OpenSource/dsh-auto-chess
安装后验证配置层,再启动(或重启)Web 界面:
dsh --profile web --dump-config   # 输出中应出现 auto-chess 层
dsh web # 重启后会话标签栏出现「自走棋」标签插件已安装到本机的webprofile(~/.dsh/profiles/web,@deepseek-ai/dsh-auto-chess以 link 依赖加入 bundle 列表)。Web 进程需重启才会扫描到新的 dshClient 包并注入客户端标签。
移除:dsh plugin --profile web remove @deepseek-ai/dsh-auto-chess 会同时移除依赖与对应层。
架构
棋局本身(状态、经济、羁绊、战斗模拟)在浏览器界面中;服务端只仲裁 AI 的准备阶段决策,因此非法回复在服务端被拒绝,不会破坏浏览器端的棋局。游戏引擎(src/game/engine.ts)是纯 TypeScript、无依赖、按状态确定性的共享代码:服务端把每次 AI 请求里的完整局面克隆一份,用与浏览器完全相同的引擎逐条校验并应用模型返回的操作数组,返回「整批合法」的操作列表与推理文本;浏览器再用同一引擎把接受的操作用在自己的权威状态上——两边永远不会漂移。
模型调用
自走棋决策请求(Auxiliary auto-chess action request)
What the model sees
每次 AI 决策都是发往所选 provider/model 路由的一次独立辅助请求。系统提示词要么是用户编辑后的文本,要么是包默认文本(完整规则、严格 JSON 数组返回格式、正确案例、错误示范、基本策略);唯一的用户消息包含该侧棋手的完整局面(生命、金币、经验/等级、上场名额、备战区棋子 JSON、棋盘布阵 JSON、当前羁绊、商店 JSON、上一轮战斗结果、对手已知阵容——上场数量、星级构成、种族/职业计数与预估战力),以及(重试时)上一次非法回复与拒绝原因。决策请求还可携带思考档位(off/high/max):仅当所选模型声明支持该档位时,服务端才会把它作为请求的 reasoning effort 转发;不支持的档位回落到模型自身默认值。可选的按请求 actionTimeoutMs 与 maxActionOutputTokens 覆盖值只对本次请求替换配置默认值。回复中的推理块会随操作结果以 reasoning 字段返回给浏览器。
模型返回一个 JSON 数组(最多 4 个操作):{"action":"buy","name":"..."}、{"action":"sell","chess_id":N}、{"action":"move","chess_id":N,"pos":[r,c]}、{"action":"upgrade"}、{"action":"refresh"}、{"action":"end_prep"}。服务端对整批操作做合法性校验(金币、备战区上限、上场上限、坐标越界、格子占用、id 存在性等),任何一条不合法都会拒绝整批并带纠正反馈重试(默认最多 3 次);最后一次失败会返回 error 与 lastText/lastReason,浏览器据此显示错误与「重试」按钮。
Token effect
辅助请求按局面构造成本消耗 token(约 1-2 KB 的局面文本 + 系统提示词 + maxActionOutputTokens,默认 32000)。高于 off 的思考档位会增加模型的思考 token,计入同一个输出预算——推理模型可能把大部分预算花在思考上,因此回复被截断时只要 JSON 数组完整仍会被解析,只有 JSON 丢失才触发重试。该请求与任何 agent 对话相互独立,绝不写入会话日志。
KV Cache effect
辅助请求是独立的模型请求;其提示词随每个棋局位置变化,因此与 agent 流量之间没有稳定的共享前缀。用户编辑系统提示词会整体替换文本,使 provider 侧的跨局前缀复用失效;默认提示词只在未编辑时保持稳定。
配置
所有字段都有 loader 默认值;无库级默认值。
| 键 | 说明 |
|---|---|
actionTimeoutMs | 单次 AI 决策尝试的端到端截止时间(默认 300000 毫秒,即 5 分钟);界面不再提供修改入口。 |
maxActionOutputTokens | 单次 AI 决策回复的输出 token 上限。默认 32000(较宽松,因为推理模型会把思考计入输出预算);截断的回复只要 JSON 完整仍会被解析,只有 JSON 丢失才触发重试。界面不再提供修改入口。 |
maxActionAttempts | 每次决策请求的 AI 尝试总次数;最后一次尝试附带纠正反馈(默认 3)。 |
开发
pnpm run build          # tsdown 构建 node 半部 + 浏览器 bundle,并输出类型声明
pnpm run typecheck      # tsc --noEmit
pnpm test               # vitest:引擎(经济/合成/战斗/结算)、回复解析、请求校验、提示词组装
node tests/e2e/gui-round.spec.mjs   # 端到端:另起一个 dsh web 测试实例(--port 3095,需安装本插件并配置可用模型)后跑完整一回合
本地依赖通过符号链接指向 Harness SDK checkout(~/.dsh/source/current 下的 packages/* 与 vendor/*),与 dsh-gomoku 的做法一致。


